
S.import()
描述:
用字符串中读出的内容作为记录返回成序表。
语法:
S.import(Fi:type;fmt,…;s)
备注:
用字符串S中读出的内容作为记录,最终返回成序表。
参数:
|
S |
字符串。字符串的格式:记录间用换行符隔开,字段间用自选分隔符隔开,缺省为tab键隔开。 |
|
Fi |
读出的字段,缺省读出所有。 |
|
type |
字段类型,包括:bool、int、long、float、decimal、number、string、date、time和datetime,缺省使用第一行数据类型。type为整数时表示排号键,排号数据目前只允许使用16个字节。 |
|
fmt |
日期时间格式。 |
|
s |
自选分隔符,缺省默认分隔符是tab。 |
选项:
|
@t |
f中第一行记录作为字段名,不使用本选项则使用_1,_2,…作为字段名。 |
|
@c |
s缺省时用逗号分隔。 |
|
@s |
不拆分字段,读成单字段串构成的序表,忽略参数。 |
|
@i |
结果集只有1列时返回成序列。 |
|
@q |
剥离数据项两端引号,包括标题,处理转义;中间的引号不作处理。 |
|
@a |
将单引号作为引号处理,缺省不处理,可与@q@p组合使用。 |
|
@o |
使用Excel标准转义,串中双个引号表示一个引号,其它字符不转义。 |
|
@p |
解析时处理括号和引号匹配,括号内分隔符不算,同时引号外转义也处理。 |
|
@f |
不做任何解析,简单用分隔符拆成串。 |
|
@l |
允许续行,行尾是转义字符\。 |
|
@k |
保留数据项两端的空白符,缺省将自动删除两端空白符。 |
|
@e |
Fi在串中不存在时将生成null,缺省将报错。 |
|
@d |
行内有数据不匹配类型和格式时删除该行,此时会按type检查类型;@p@q时括号和引号不匹配时也删除该行;列数不匹配算作错误。 |
|
@n |
@d出错时抛出违例,中断程序,输出出错行的内容。 |
|
@w |
将每行读成序列,返回序列的序列,列名也算作一行。 |
|
@r |
先读成串再解析,避免某些字符集的错误,使用该选项速度会慢。 |
返回值:
序表
|
|
A |
|
|
1 |
=demo.query("select * from EMPLOYEE") |
|
|
2 |
=A1.(~.array().concat@c()) |
转换为字串序列:
|
|
3 |
=A2(1).import(;",") |
选取序列中的一个字串,从字串中选出所有字段,并指定分隔符为逗号,最后返回结果为序表:
|
|
4 |
=demo.query("select EID,NAME,SURNAME from EMPLOYEE") |
|
|
5 |
= A4.export() |
|
|
6 |
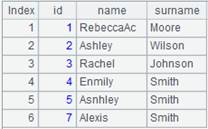
= A4.export@t(EID:id,NAME:name,SURNAME:surname;"|") |
|
|
7 |
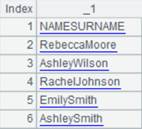
=A5.import() |
无参数,缺省分隔符为tab,用_1,_2,…作为字段名:
|
|
8 |
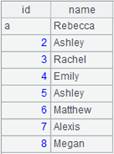
=A6.import@t(id:int,name;"|") |
选出id和name字段,分隔符为“|” :
|
|
9 |
=A6.import@f() |
使用@f选项,直接用分隔符拆成串:
|
|
10 |
1,2,"3,3",(4,4),[5,5],'6,6' |
|
|
11 |
=A10.import@c() |
使用@c选项,分隔符缺省使用逗号:
|
|
12 |
=A10.import@cp() |
使用@p选项,解析时处理括号和引号匹配:
|
|
13 |
=A10.import@cpa() |
使用@a选项,将单引号作为引号处理:
|
|
14 |
=A2(1).import@c() |
使用@c选项,分隔符缺省使用逗号:
|
|
15 |
=A5.import@s() |
使用@s选项,不拆分字段,读成单字段串构成的序表:
|
|
16 |
=A5.import@si() |
结果集只有1列时返回成序列:
|
|
17 |
"uy'd'uj" |
|
|
18 |
=A17.import() |
|
|
19 |
=A17.import@q() |
使用@q先剥离两端的引号后再转为序表,中间的引号不作处理:
|
|
20 |
f1,f2,f3 2,"dd""ff",3 |
|
|
21 |
=A20.import@coq() |
使用@o选项,串中两个引号表示一个引号:
|
|
22 |
=" abc ".import@k() |
保留两端的空白符。 |
|
23 |
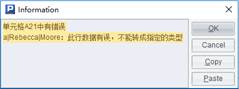
=A6.import@te(id:int,name,dept;"|") |
dept在串中不存在时生成null:
|

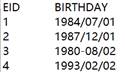
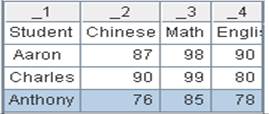
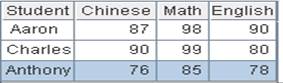
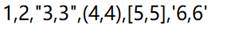


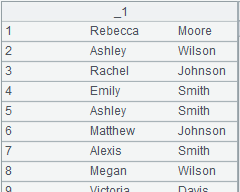


使用@d和@n选项
|
|
A |
|
|
1 |
ID Amount 2 3958 3 4 5824 5 4255 a abc 6 9275 |
|
|
2 |
=A1.import@t() |
将A1格字符串内容读成序表,返回结果如下:
|
|
3 |
=A1.import@dt() |
使用@d选项,行内有数据不匹配类型和格式、列数和第一行不匹配的行都被删除掉,返回结果如下:
|
|
4 |
=A1.import@nt() |
使用@n选项,@d检查出错时抛出违例,提示信息如下: Error in cell A4 3: Wrong format row data. |


使用@w选项:
|
|
A |
|
|
1 |
ID Amount 2 3958 3 4 5824 5 4255 a abc 6 9275 |
|
|
2 |
=A1.import@w(;) |
使用@w选项,将行读成序列的序列:
|

使用@l选项:
|
|
A |
|
|
1 |
11,22,"3",\ 33,44,55, 66,77,88 |
|
|
2 |
=A1.import@l() |
使用@l选项,行尾为转义符\时允许续行:
|

相关概念: