
脚本格式
SQLazy 脚本文件以 .nsql为扩展名,是纯文本文件,每行代表一个步骤。
以下面的脚本为例,从内存表EMPLOYEE中筛出销售部员工,按薪资降序排序,并将薪资增加50%后的数值作为新列[涨薪后薪资]的值:
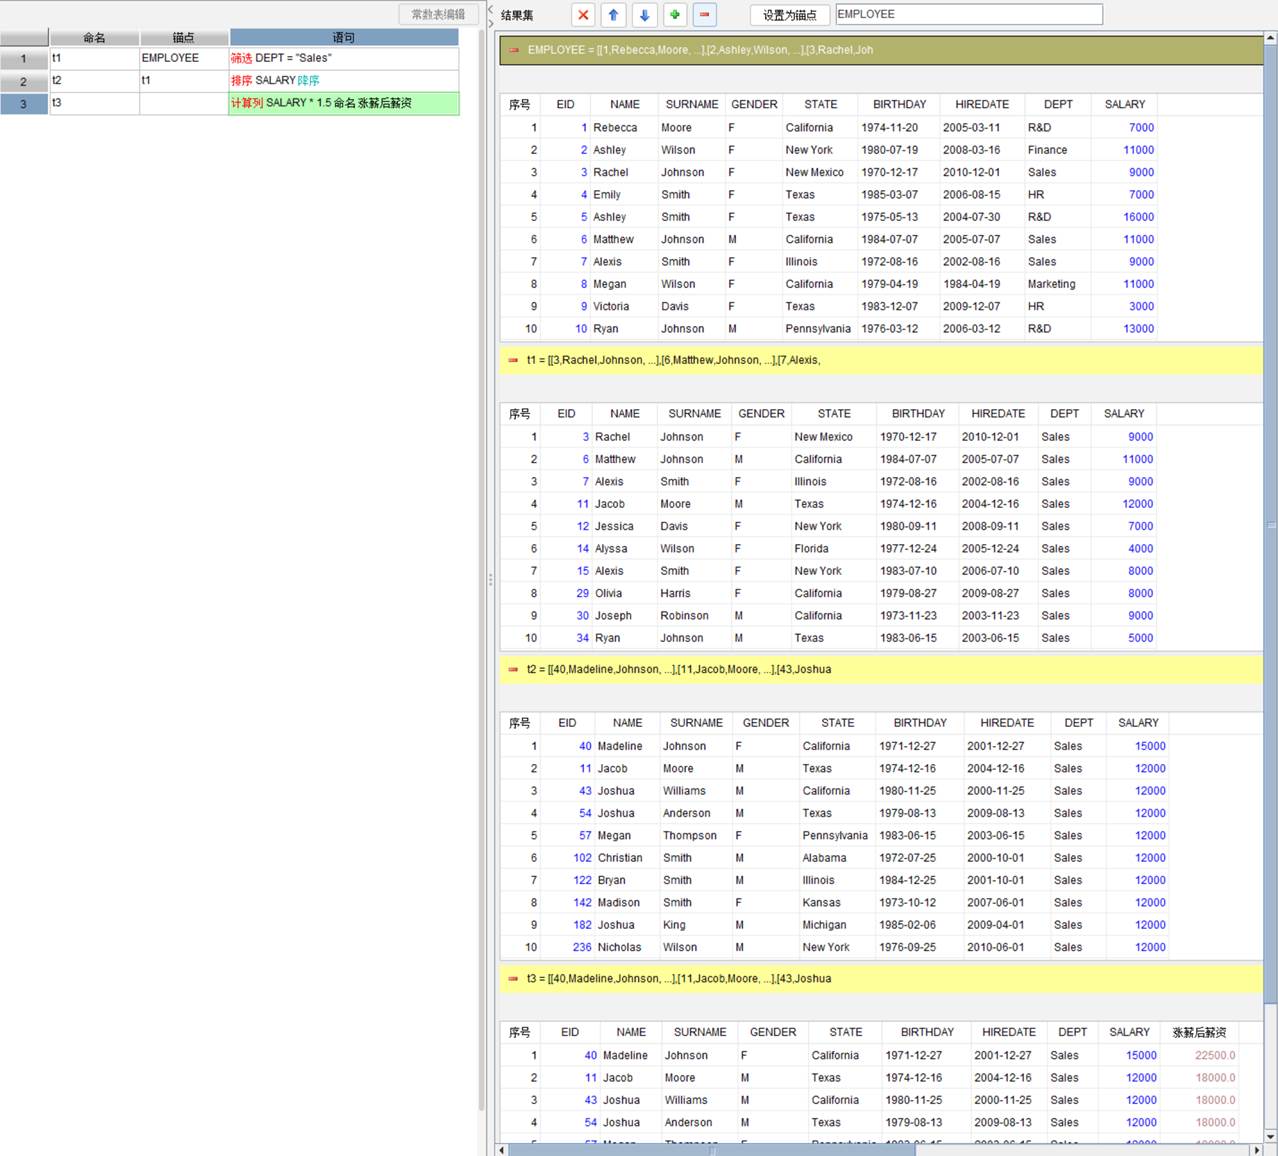
每行由命名、锚点、语句三部分组成,点击 执行后,每行产出一个中间结果表,比如上例中第1行对应结果集t1、第2行对应结果集t2、第3行对应结果集t3。
Ø 行结构
|
部分 |
是否必填 |
说明 |
|
命名 |
可选 |
定义当前行结果表的名称,供后续步骤引用,命名不得重复。 |
|
锚点 |
可选 |
当前行处理的对象,有以下三种写法: 内存表:如 EMPLOYEE,直接从内存表取数; 前面行的命名:如第2行锚点为t1,即引用前面某一步的结果表命名; 留空:承接上一步的结果表,如第3行锚点为空表示处理对象为第2行的结果表。 |
|
语句 |
必填 |
当前行的功能语句,由[功能名+参数]组成。 |
Ø 语法规则
|
规则 |
说明 |
|
每步一个功能 |
每行只能包含一个功能,但语句内函数可嵌套多个。 |
|
跨步引用 |
用 命名、命名.字段 等形式引用其他步骤产出的结果,如t1、t1.NAME。 |
|
语句不换行 |
每步语句必须写在同一行内,严禁换行。 |
|
参数分隔 |
功能名和参数、参数和参数之间必须用符号隔开,可以是空格、逗号或分号:功能和参数之间推荐用空格,同类参数之间用逗号,异类参数之间用分号。 |
|
保留字命名 |
min、max、end、start、date、time、inc、cum、sum、avg、count 等保留字若要作为命名/字段名,必须加单引号。例如max命名 'max' 。 |
|
注释 |
用 // 注释行 ,或者用快捷键ctrl+/ 注释选中行。 |