
编译
编译功能可以将SQLazy的分步脚本翻译成目标数据库的SQL或润乾的SPL语言,实现跨数据库的可移植运行。
编译为 SQL
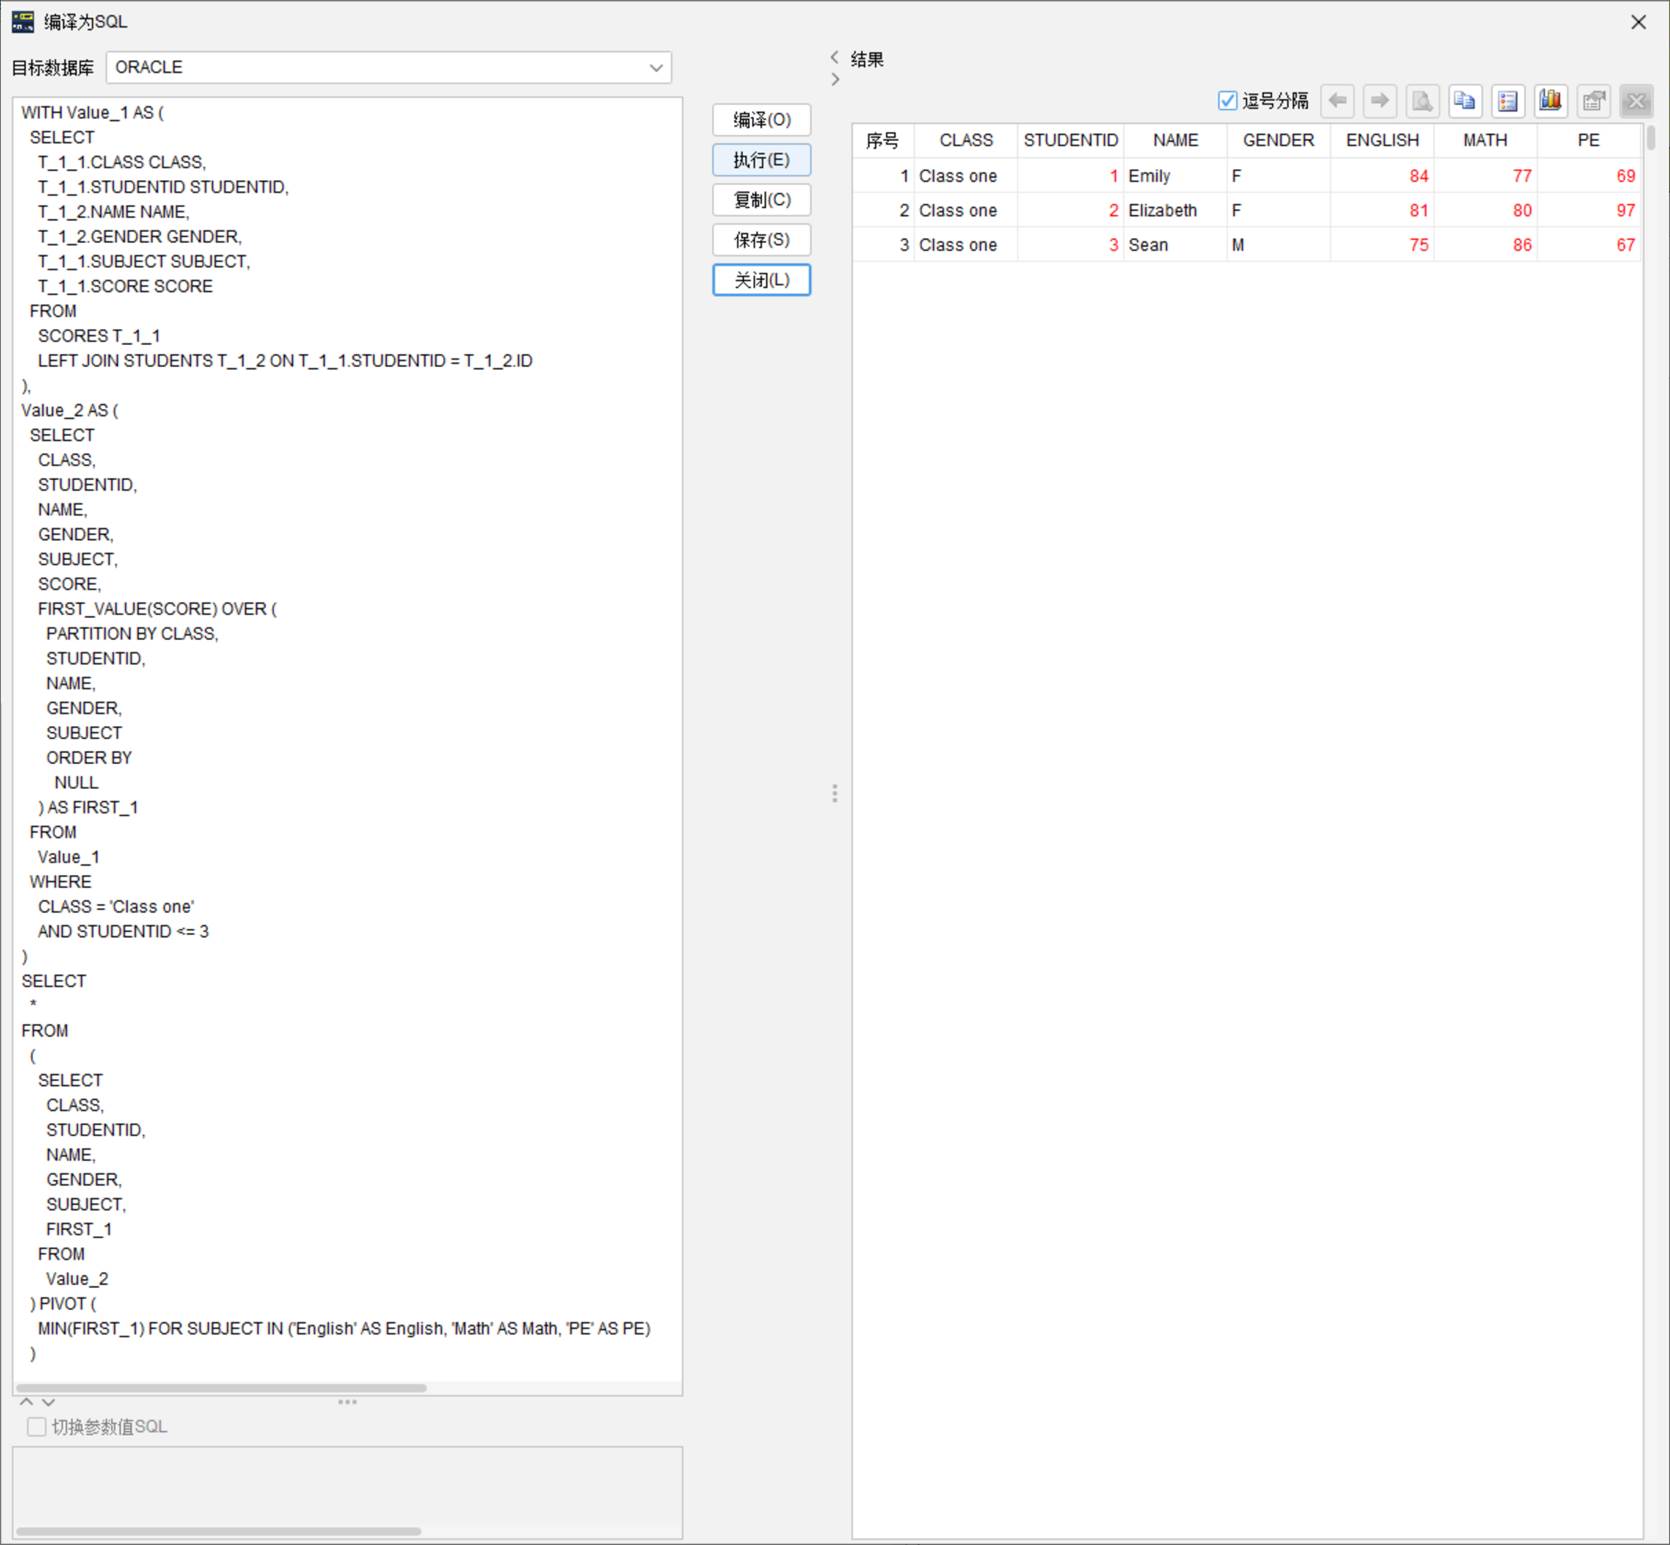
连接数据源后,可通过【编译SQL】功能将nsql脚本转换为目标数据库可直接执行的SQL语句。
例如将下面stu_str.nsql文件中的第3行编译为ORACLE数据库可用的SQL语句:
|
命名 |
锚点 |
语句 |
|
v1 |
SQL "select CLASS, STUDENTID,fk1.NAME as NAME,fk1.GENDER as GENDER,SUBJECT,SCORE from SCORES" |
|
|
v2 |
筛选 CLASS="Class one" 且 STUDENTID<=3 |
|
|
v3 |
旋转 分组 CLASS, STUDENTID ,NAME,GENDER ; 标题列 SUBJECT; 取值列 SCORE |
首先选中要编译的目标行,点击[程序] - [编译SQL]打开编译为SQL窗口,选择ORACLE目标数据库,点击[编译]按钮,左侧会自动生成SQL语句,点击执行则会连接ORACLE数据库执行SQL查询并将结果返回到右边区域:
目前对数据库类型的支持情况如下:
|
数据库 |
状态 |
数据库 |
状态 |
|
MySQL |
已支持 |
PostgreSQL |
已支持 |
|
Oracle |
已支持 |
MS SQL Server |
已支持 |
|
Snowflake |
已支持 |
BigQuery |
已支持 |
|
DuckDB |
已支持 |
Hive |
已支持 |
|
SparkSQL |
已支持 |
DAMENG |
已支持 |
|
ClickHouse |
已支持 |
DORIS |
已支持 |
|
KingBase |
已支持 |
OPENGAUSS |
已支持 |
|
OceanBase_MySQL / OceanBase_Oracle |
已支持 |
PolarDB_PostgreSQL |
已支持 |
编译为 SPL
对于极其复杂的分析场景(如 SQL 无法表达或性能受限),SQlazy还可以生成SPL代码作为替代方案。SPL 是 esProc 的原生脚本语言,表达能力比SQL更强,支持有序计算和过程化逻辑。
点击后,会在.nsql文件同目录下自动生成 .spl 文件 ,比如将上面的stu_str.nsql编译为SPL,结果如下:
|
|
A |
|
1 |
>GDtable=demo.query("select * from GDtable") |
|
2 |
>SCORES=demo.query("select * from SCORES") |
|
3 |
>EMPLOYEE=demo.query("select * from EMPLOYEE") |
|
4 |
>STUDENT=demo.query("select * from STUDENT") |
|
5 |
=v1=demo.query("SELECT T_1_1.CLASS CLASS,T_1_1.STUDENTID STUDENTID,T_1_2.NAME NAME,T_1_2.GENDER GENDER,T_1_1.SUBJECT SUBJECT,T_1_1.SCORE SCORE from {SCORES\} T_1_1 LEFT JOIN \"STUDENT\" T_1_2 ON T_1_1.STUDENTID=T_1_2.ID") |
|
6 |
=v2=v1.select(CLASS=="Class one"&&STUDENTID<=3) |
|
7 |
=v3=v2.pivot@s(CLASS,STUDENTID,NAME,GENDER;SUBJECT,top@1(1,0,SCORE);) |